AvaritCall · Redaktion
Telefon-STT mit WER und der Genauigkeit wichtiger Felder testen
Bewerten Sie Telefon-STT über die allgemeine WER hinaus. Nutzen Sie repräsentative türkische Gespräche, passende Codecs und getrennte Prüfungen für Namen, Nummern und Termine.
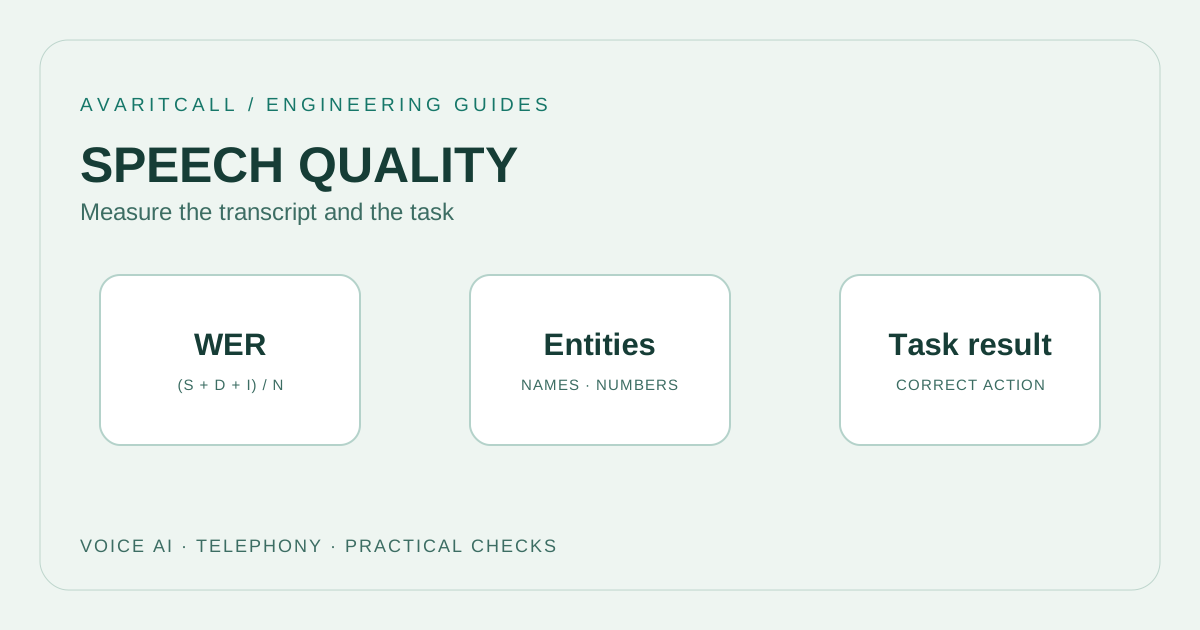
Testen Sie ein Speech-to-Text-System mit repräsentativen türkischen Aufnahmen, die den tatsächlichen Telefonweg durchlaufen. WER beschreibt allgemeine Wortfehler; messen Sie Namen, Bestellnummern und Termindaten zusätzlich. Gute Ergebnisse mit sauberen Mikrofonaufnahmen belegen keine Telefonleistung. Für einen belastbaren Vergleich brauchen Sie dieselben Aufnahmen, Referenztranskripte und Bewertungsregeln.
1. Türkische Telefongespräche im Datensatz abbilden
Der Kerndatensatz sollte Gespräche enthalten, die dem tatsächlichen Arbeitsablauf ähneln. Im Support gehören Produktnamen, Problembeschreibungen, Adressen und Bestellnummern dazu. Am Empfang sind Namen, Daten, Uhrzeiten und Korrekturen wichtig. Kennzeichnen Sie langsames und schnelles Sprechen, regionale Aussprache, unterschiedliche Geräte, Hintergrundgespräche und unterbrochene Sätze als getrennte Gruppen. Berücksichtigen Sie auch fremdsprachige Markennamen innerhalb türkischer Sätze.
Dominieren einfache Aufnahmen, kann der Durchschnitt schwierige Gespräche verdecken. Beschreiben Sie zuerst die erwartete Gesprächsverteilung und sammeln Sie anschließend genügend Beispiele für jede wichtige Gruppe. Bewerten Sie kurze Anweisungen getrennt von langen Erklärungen. Kontrollierte Leseaufnahmen helfen beim Prüfen bestimmter Laute und Zahlen; natürliche Telefondialoge sind ebenfalls erforderlich. Trennen Sie Entwicklung und abschließende Bewertung nach Sprechern und Gesprächssitzungen. Verwenden Sie den abschließenden Testsatz nicht fortlaufend zur Optimierung der Einstellungen.
2. WER mit einer gemeinsamen Referenz berechnen
WER = (S + D + I) / N. S zählt Ersetzungen, D Auslassungen, I Einfügungen und N Referenzwörter. Für einen Prozentwert wird mit 100 multipliziert. [1] NISTs SCTK/sclite kann Referenz und Systemtranskript ausrichten und Wortfehler zählen. [2]
Synthetisches Rechenbeispiel: Bei N=100, S=5, D=3 und I=2 beträgt die WER 10 %. Verwenden Sie für die tatsächliche Bewertung von Menschen erstellte und geprüfte Referenztranskripte. Legen Sie Regeln für Satzzeichen, Großschreibung, Abkürzungen und Zahlendarstellung vorab fest. Unachtsame Umwandlungen von türkischem I, ı, İ und i können das Ergebnis verfälschen. Bewahren Sie rohe und normalisierte Ausgaben gemeinsam auf und ändern Sie die Regeln nicht nach Sichtung der Ergebnisse. Berechnen Sie die gesamte WER aus aufsummierten Fehlern und Referenzwörtern, statt Gesprächsprozente einfach zu mitteln.
3. Wichtige Felder des Arbeitsablaufs getrennt messen
Ein Füllwort und eine falsche Ziffer in einer Telefonnummer können die WER ähnlich beeinflussen, obwohl ihre Folgen sehr unterschiedlich sind. Die folgenden Feldmetriken sind vorgeschlagene Bewertungsregeln, die diesen Unterschied sichtbar machen. Zeigen Sie jeweils die Zahl korrekter Fälle und die Gesamtzahl der geprüften Fälle. Ein Prozentwert allein kann bei einer kleinen Gruppe zu übermäßigem Vertrauen führen.
| Feld | Vorgeschlagene Kennzahl | Bewertungsregel |
|---|---|---|
| Namen und Entitäten | Korrekte Felder / markierte Felder | Vorab definierte gleichwertige Schreibweisen nutzen |
| Telefon- oder Bestellnummer | Exakte Folgen / markierte Folgen | Ziffernfolge und führende Nullen erhalten |
| Datum und Uhrzeit | Korrekte Deutungen / markierte Ausdrücke | Datum und Uhrzeit des Gesprächs festlegen |
| Falsche wichtige Bestätigung | Mit falscher Information bestätigte Aufgaben | Fehlerart je Gespräch untersuchen |
Die Umwandlung von Zahlen in Wörter oder Ziffern kann den Textvergleich erleichtern. Sie darf eine falsche Nummer jedoch nicht scheinbar richtig machen. Für Daten gilt dieselbe Sorgfalt: Der Ausdruck morgen lässt sich nur mit dem Datum des Gesprächs bewerten. Trennen Sie daher die Transkriptbewertung von der späteren Interpretation eines Feldes.
4. Codec und Abtastung an echte Gespräche anpassen
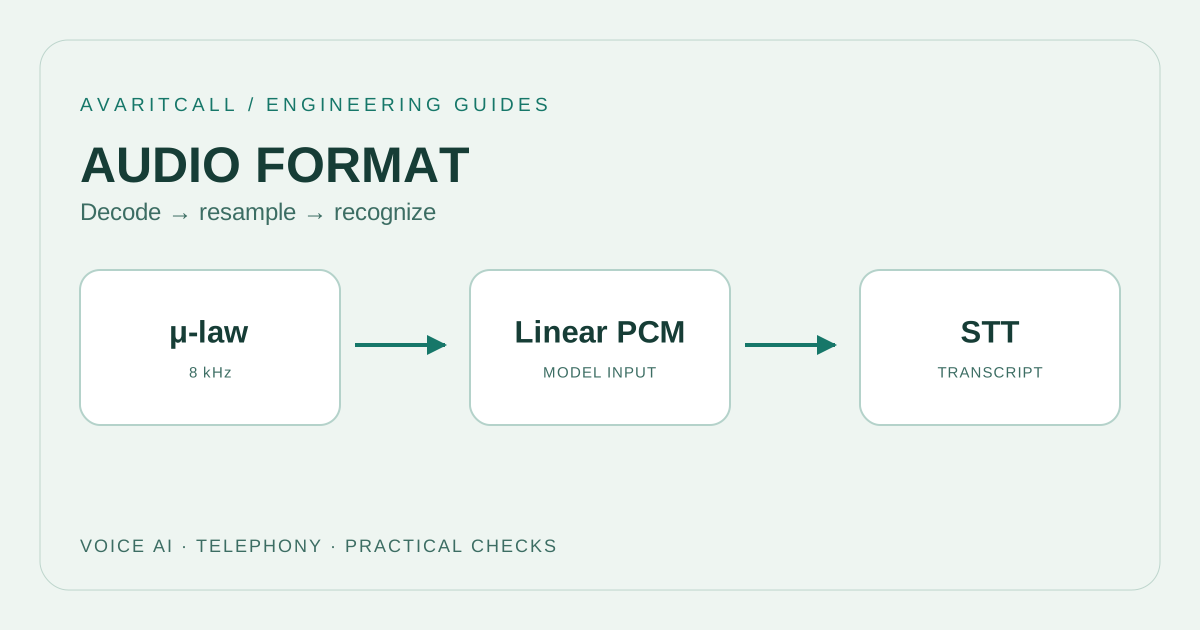
Codec, Abtastrate und Aufzeichnungspunkt des Testaudios sollten dem tatsächlichen STT-Eingang entsprechen. Eine andere Dateiendung verwandelt eine Desktopaufnahme nicht in Telefon-Audio. Die Umrechnung einer schmalbandigen Aufnahme von 8 kHz auf 16 kHz stellt verlorene Frequenzen nicht wieder her; neue Abtastwerte entstehen aus dem vorhandenen Signal. Die Torchaudio-Dokumentation beschreibt dafür bandbegrenzte Interpolation. [3]
In einem beispielhaften Termingespräch sagt ein Nutzer Kadıköy’de yarın iki buçuk und korrigiert anschließend mit saat üç olsun die Uhrzeit. Speichern Sie Zwischen- und Endtranskript und prüfen Sie, ob das endgültige Datum und die Uhrzeit in die richtigen Felder gelangen. Vergleichen Sie dasselbe Gespräch ohne Netzstörung und mit kontrollierter Störung. Entstand der Fehler beim Dekodieren, bei der Sprachsegmentierung oder beim Verarbeiten der Korrektur? Ergänzen Sie die Dateiprüfung anschließend durch eine Prüfung im tatsächlichen Telefonweg.
5. Checkliste für wiederholbare Bewertungen
- Erfassen Sie Aufnahme-ID, Gesprächsszenario, Sprechergruppe, Codec, Abtastrate und Kanalbedingungen im Datensatz.
- Lassen Sie Referenzen von einer zweiten Person prüfen. Vereinbaren Sie vorab eine Kennzeichnungsregel für unverständliche Abschnitte.
- Verwenden Sie für alle Kandidaten denselben Testsatz. Dokumentieren Sie Modellversion, Spracheinstellungen, Wörterbücher und sämtliche Vorverarbeitungsschritte.
- Berichten Sie Gesprächsgruppen, wichtige Felder und Fehlerbeispiele zusätzlich zur gesamten WER. Vermischen Sie vorläufige Streaming-Ausgaben nicht mit Endtranskripten.
- Definieren Sie Abnahmekriterien anhand der Aufgabe vor dem Vergleich. Bestätigen Sie das Ergebnis anschließend mit neuen echten Gesprächsbeispielen.
6. Häufige Fragen
Ist die niedrigste WER immer die beste Wahl? Nein. Ein System kann allgemeine Gespräche gut erkennen und dennoch häufige Namen oder Nummern Ihres Arbeitsablaufs verfehlen. Ergänzen Sie die Entscheidung um Feldgenauigkeit bei repräsentativen Aufgaben und das Gesprächserlebnis.
Reicht ein kleiner Testsatz? Er kann erste offensichtliche Probleme zeigen. Verallgemeinern Sie erst, wenn häufige und schwierige Gruppen jeweils genügend Beispiele enthalten. Zeigen Sie die Fallzahlen und prüfen Sie, ob einzelne Sprecher oder Szenarien die Ergebnisse dominieren.
Wie vergleicht man eine neue STT-Version? Bewerten Sie den unveränderten abschließenden Testsatz erneut mit denselben Regeln. Hören Sie Verbesserungen und Verschlechterungen je Gespräch an. Der Gesamtdurchschnitt kann eine Verschlechterung eines wichtigen Feldes verbergen; bewahren Sie deshalb genügend Einzelheiten zur Erklärung der Änderung auf.
- [1]KWS15 Keyword Search Evaluation Plan, section 6: Speech-to-Text Evaluation — National Institute of Standards and Technology (NIST), 2015-02-03 (abgerufen: 2026-10-01)
- [2]NIST SCTK: sclite scoring documentation — National Institute of Standards and Technology (NIST) (abgerufen: 2026-10-01)
- [3]Audio Resampling tutorial — PyTorch / Torchaudio (abgerufen: 2026-10-01)