AvaritCall · Redaktion
Streaming-TTS: die Zeit bis zum ersten Ton messen
Erste Audiodaten, vollständige Synthese und hörbare Wiedergabe sind verschiedene Zeitpunkte. Prüfen Sie Streaming-TTS mit klaren Messpunkten für Textteile, feste Sätze und Unterbrechungen.
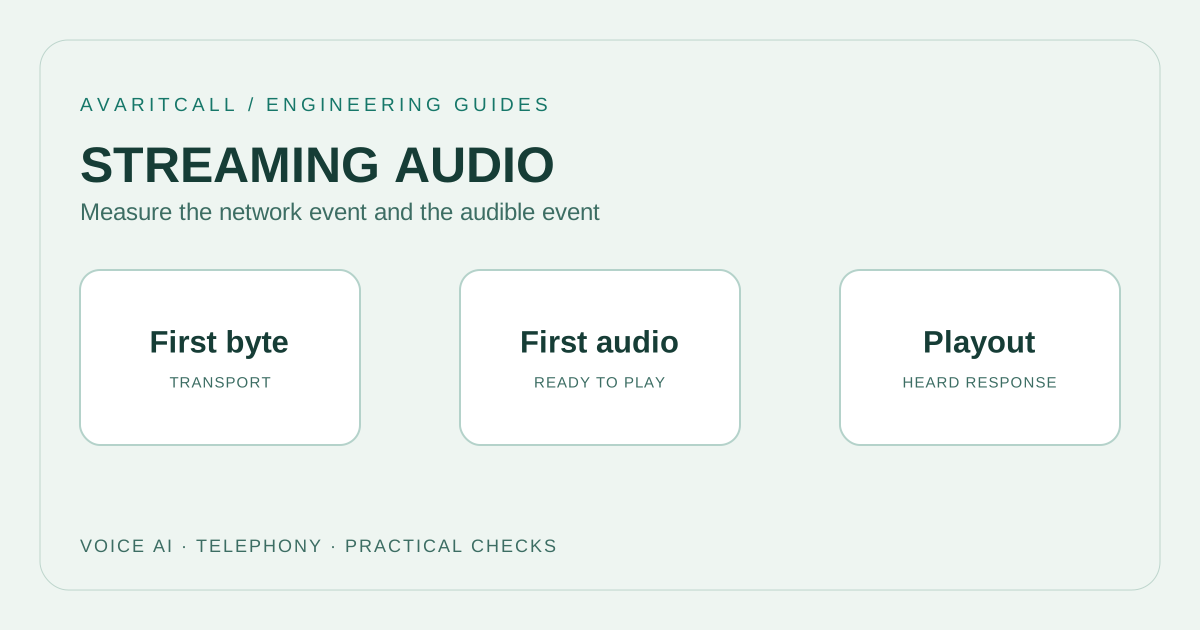
Streaming-TTS ermöglicht die Wiedergabe verfügbarer Audiodaten, bevor die gesamte Antwort erzeugt ist. Definieren Sie vor der Messung die Zeitgrenzen: Audiodaten nach einer TTS-Anfrage zu empfangen und eine Antwort tatsächlich zu hören sind verschiedene Ereignisse. Bewerten Sie die Aufteilung des Textes neben der Geschwindigkeit auch anhand vollständiger Sätze und des Unterbrechungsverhaltens.
1. Erste Audiodaten, Abschluss und Wiedergabe trennen
Microsoft beschreibt die First-Byte-Latenz bis zum Empfang des ersten Audioabschnitts und die Abschlusslatenz bis zum Empfang aller Audiodaten. [1] Definieren Sie für Ihre Bewertung zusätzlich, welches Ereignis TTFA bezeichnet. Das erste Byte, erstmals dekodierbare Audiodaten und der erste hörbare Abtastwert können verschiedene Grenzen bilden. Vergleichen Sie fremde TTFA-Werte erst, wenn deren Definition bekannt ist.
| Messung | Anfang und Ende | Zweck der Untersuchung |
|---|---|---|
| Erste nutzbare TTS-Daten | Anfrage gesendet → nutzbares Audio empfangen | Start von Erzeugung und Übertragung prüfen |
| Wiedergabestart | Anfrage gesendet → erster hörbarer Ton | Dekodierung und Wiedergabewartezeit sichtbar machen |
| Abschluss | Anfrage gesendet → letzte Audiodaten empfangen | Erzeugung der vollständigen Antwort messen |
| Gesprächsantwort | Nutzer spricht zu Ende → Antwort hörbar | Gesamten Gesprächsablauf bewerten |
Verwechseln Sie die Wiedergabedauer nicht mit der Erzeugungszeit. Eine lange Antwort kann früh beginnen, während ihr letzter Teil später eintrifft. Verwenden Sie möglichst eine gemeinsame Zeitbasis und dokumentieren Sie die Zuordnung von Zeitstempeln verschiedener Geräte. Zeigen Sie langsame Versuche und Fallzahlen zusätzlich zum Mittelwert. Nur unveränderte Messgrenzen erlauben einen aussagekräftigen Vergleich.
2. Textabschnitte und Audioabschnitte unterscheiden
Eine Audioausgabe in Abschnitten bedeutet nicht automatisch, dass die Schnittstelle auch schrittweise Texteingaben unterstützt. Microsoft behandelt Audio-Streaming und Text-Streaming getrennt. [1] Prüfen Sie das Eingabeverhalten der verwendeten Schnittstelle, bevor Sie den Versuch planen. Auch ein empfangener Audioabschnitt muss nicht an einer sinnvollen Satzgrenze enden.
Kleine Textteile ermöglichen einen früheren Start, können jedoch Wörter, Zahlen oder Betonung von ihrem Zusammenhang trennen. Größere Teile bieten mehr Kontext, warten aber auf zusätzlichen Text. Testen Sie kurze Begrüßungen, längere Erklärungen und vorgelesene Zahlen getrennt. Eine einzige Abschnittsgröße muss nicht für alle Aufgaben geeignet sein. Halten Sie außerdem Byte-Größe und Textlänge in der Konfiguration und in den Versuchsdaten auseinander. Sonst beeinflusst eine Änderung mehrere Schritte, ohne ihre Ursache sichtbar zu machen.
3. Einen Satz vor der Ausgabe festlegen
Während ein Sprachmodell eine Antwort erzeugt, können die letzten Wörter noch entstehen. Bereits gesprochene Information lässt sich nicht unbemerkt wie Bildschirmtext korrigieren. Legen Sie einen eindeutigen Entscheidungspunkt für sprechfertigen Text fest. Satzzeichen können Hinweise liefern. Unvollständige Daten, angefangene Zahlen und noch nicht abgeschlossene Verneinungen können jedoch weitere Prüfung benötigen.
Warten Sie beispielsweise vor der Ansage eines Termins auf die vollständige Tages- und Uhrzeitangabe. Soll die Antwort früher beginnen, kann ein kurzer bereits geprüfter Satz vorausgehen; Einzelheiten folgen in einem eigenen Satz. Kennzeichnen Sie im Versuch auch früh beginnende Ausgaben mit falscher oder unvollständiger Information. Ordnen Sie freigegebenen Text, erzeugtes Audio und tatsächlich wiedergegebenen Abschnitt einander zu. Dadurch lässt sich eine irreführende Ausgabe gezielter untersuchen.
4. Eine unterbrochene Empfangsantwort testen
In einem beispielhaften Empfangsgespräch beschreibt der Assistent Öffnungszeiten, während der Anrufer nach einem anderen Tag fragt. Die Erzeugung zu stoppen reicht möglicherweise nicht: Bereits eingereihte Audiodaten können weiterlaufen. Erfassen Sie den Beginn der Nutzersprache, die Unterbrechungsentscheidung und den letzten hörbaren Ton der alten Antwort getrennt.
Prüfen Sie anschließend, ob die neue Antwort zur neuen Frage gehört. Hören Sie darauf, ob verspätete Daten der alten Erzeugung zwischen neue Abschnitte gelangen. Wiederholen Sie den Versuch mit kurzer Antwort, langer Erklärung und zwei unmittelbar folgenden Unterbrechungen. Ziel sind ein früher Beginn und eine korrekte Reihenfolge beim Sprecherwechsel. Nehmen Sie hörbare Lücken und vollständige Sätze in die Abnahmekriterien auf. Ein schneller erster Ton darf eine stockende Fortsetzung nach der Unterbrechung nicht verdecken.
5. Checkliste für Messung und Änderung
- Dokumentieren Sie Anfangs- und Endereignis von TTFA, Zeitbasis und Audioformat beim Testergebnis.
- Messen Sie erste Audiodaten, Wiedergabestart und Abschluss derselben Antwort. Vermischen Sie keine Zeiten unterschiedlicher Antworten.
- Halten Sie Audioformat, Testsatz und Netzwerkpfad konstant, während Sie die Textaufteilung verändern.
- Hören Sie Namen, Daten, Zahlen und Verneinungen an. Kennzeichnen Sie schnelle Ausgaben, deren Bedeutung beschädigt wurde.
- Prüfen Sie, dass altes Audio nach einer Unterbrechung endet, verspätete Abschnitte zugeordnet bleiben und die neue Antwort in richtiger Reihenfolge läuft.
- Beobachten Sie erste Audiodaten und Wiedergabewarteschlangen bei steigender Parallelität. Berichten Sie die Zahl der Versuche.
6. Häufige Fragen
Hat der Nutzer die Antwort gehört, sobald das erste Byte eintrifft? Nicht zwingend. Audio muss dekodierbar werden, in die Wiedergabe gelangen und den Empfänger erreichen. Machen Sie die Wartezeiten dieser Schritte sichtbar.
Soll jedes Wort sofort an TTS gehen? Eine Wortgrenze ist nicht immer eine Bedeutungsgrenze. Vergleichen Sie denselben Satz mit unterschiedlichen Aufteilungen und prüfen Sie Zahlen, Daten und Betonung.
Beschleunigt eine kürzere TTFA das gesamte Gespräch? Sie verbessert einen Abschnitt. Messen Sie zusätzlich die Zeit vom Sprechende bis zur hörbaren Antwort und prüfen Sie die Fortsetzung nach Unterbrechungen, bevor Sie den Gesamteindruck beurteilen.
- [1]Lower speech synthesis latency using Speech SDK — Microsoft Learn, 2026-02-25 (abgerufen: 2026-10-01)